Quattro specialità in un jolly. Un lavoro da Artistagiano: la tecnica non arriva dopo l’idea e l’arte non arriva dopo il lavoro. Si costruisce, si usa, si osserva; passando e ripassando il materiale si accantona, decanta, cambia funzione e diventa struttura.
Questa non nasce come recensione di MateClaw. Nasce mentre sto facendo altro.
Sto costruendo un Second Brain personale in Obsidian, Ologrammio. Voglio poterlo interrogare senza ridurlo a una cartella piena di file. Installo MateClaw, gli collego Ollama per gli embedding locali, gli do accesso in sola lettura al vault e costruisco un Employee dedicato. All’inizio si chiama Ologrammio Reader; poi capisco cosa deve fare davvero e lo rinomino Panoramio: non deve semplicemente leggere. Deve fare una panoramica sul materiale, attraversare nodi, documenti, rimandi, esperienze e fonti.
Nel frattempo, mentre il ponte prende forma, saltano fuori delle tegole storte.
Queste pagine sono i miei cartelli nel bosco: se qualcun altro passa di qui, magari evita di cozzarci o inciampare.
Accaduto, cosa stavo cercando di fare
La catena costruita è questa:
Obsidian / Ologrammio
        │
        │ filesystem source
        ▼
MateClaw Wiki KB (Lazy ingest)
        │
        │ embeddings locali
        ▼
Ollama / nomic-embed-text
        │
        │ semantic retrieval
        ▼
Panoramio — ReAct / Native Loop
        │
        │ OpenAI ChatGPT OAuth
        ▼
GPT-5.5
Obiettivo operativo:
materiale personale
→ indicizzazione
→ ricerca semantica
→ ricostruzione panoramica
→ fonti verificabili
→ nessuna scrittura autonoma nel vault
Governance voluta:
Panoramio cerca / legge / confronta / propone
        ↓
Scriba revisiona e corregge
        ↓
Josta approva
        ↓
solo dopo, eventualmente, si scrive
MateClaw non è autorizzato a creare, modificare o cancellare contenuti in Ologrammio.
Ambiente del laboratorio
MateClaw: 2.3.0
Runtime: Native Loop
Employee: ReAct (Tool Calling)
Employee name: Panoramio
Max iterations: 6 durante i test iniziali
Model: OpenAI ChatGPT (OAuth) / GPT-5.5
Knowledge Base: Ologrammio
KB mode: Lazy
Embedding provider: Ollama locale
Embedding model:
nomic-embed-textEmbedding dimensions: 768
Vault: Obsidian / Ologrammio
Permissions: read-only, R yes, C/U/D no, write policy
denySkills: explicit no-skills
User-pickable tools: explicit none
Wiki tools: disponibili tramite il binding della KB
Sorgente MateClaw ispezionato durante il bughunting: commit 6bbd3ac4dac0c04f00f6a95bde6689766f1c51e5.
Accadere, dal setup al Panoramio
1. MateClaw incontra Ologrammio
Il vault Obsidian viene configurato come source_directory della KB Ologrammio.
Con Lazy ingest MateClaw estrae, normalizza, chunkizza e indicizza i materiali senza dover generare preventivamente una pagina Wiki per ogni file. Questo è fondamentale: Panoramio deve poter interrogare il materiale indicizzato anche quando la Wiki compilata contiene solo poche pagine di sistema.
2. Ollama entra sotto il pavimento
Installazione locale di Ollama, API su:
http://127.0.0.1:11434
Modello embedding:
ollama pull nomic-embed-text
Test in MateClaw:
Passed · 768 dimensions
Da qui la ricerca semantica del vault non dipende da un embedding remoto.
3. Ologrammio Reader diventa Panoramio
Il nome precedente descriveva un’azione troppo piccola. Reader legge. Panoramio deve guardare il paesaggio.
Il suo compito operativo diventa:
ricerca semantica prima delle risposte sui contenuti del vault;
fonti esplicite;
distinzione fra fonte e inferenza;
sola lettura;
nessuna modifica persistente;
per richieste panoramiche: più sotto-query,
topK=20quando disponibile, deduplicazione e sintesi finale.
Quando la regola panoramica entra in funzione, una singola domanda larga attiva una batteria di ricerche, Progress Ledger e raccolta di evidenze prima della risposta.
Evidenza E11, Panoramio apre il grandangolo: più Semantic Search KB, Progress Ledger e letture intermedie prima dell’output.
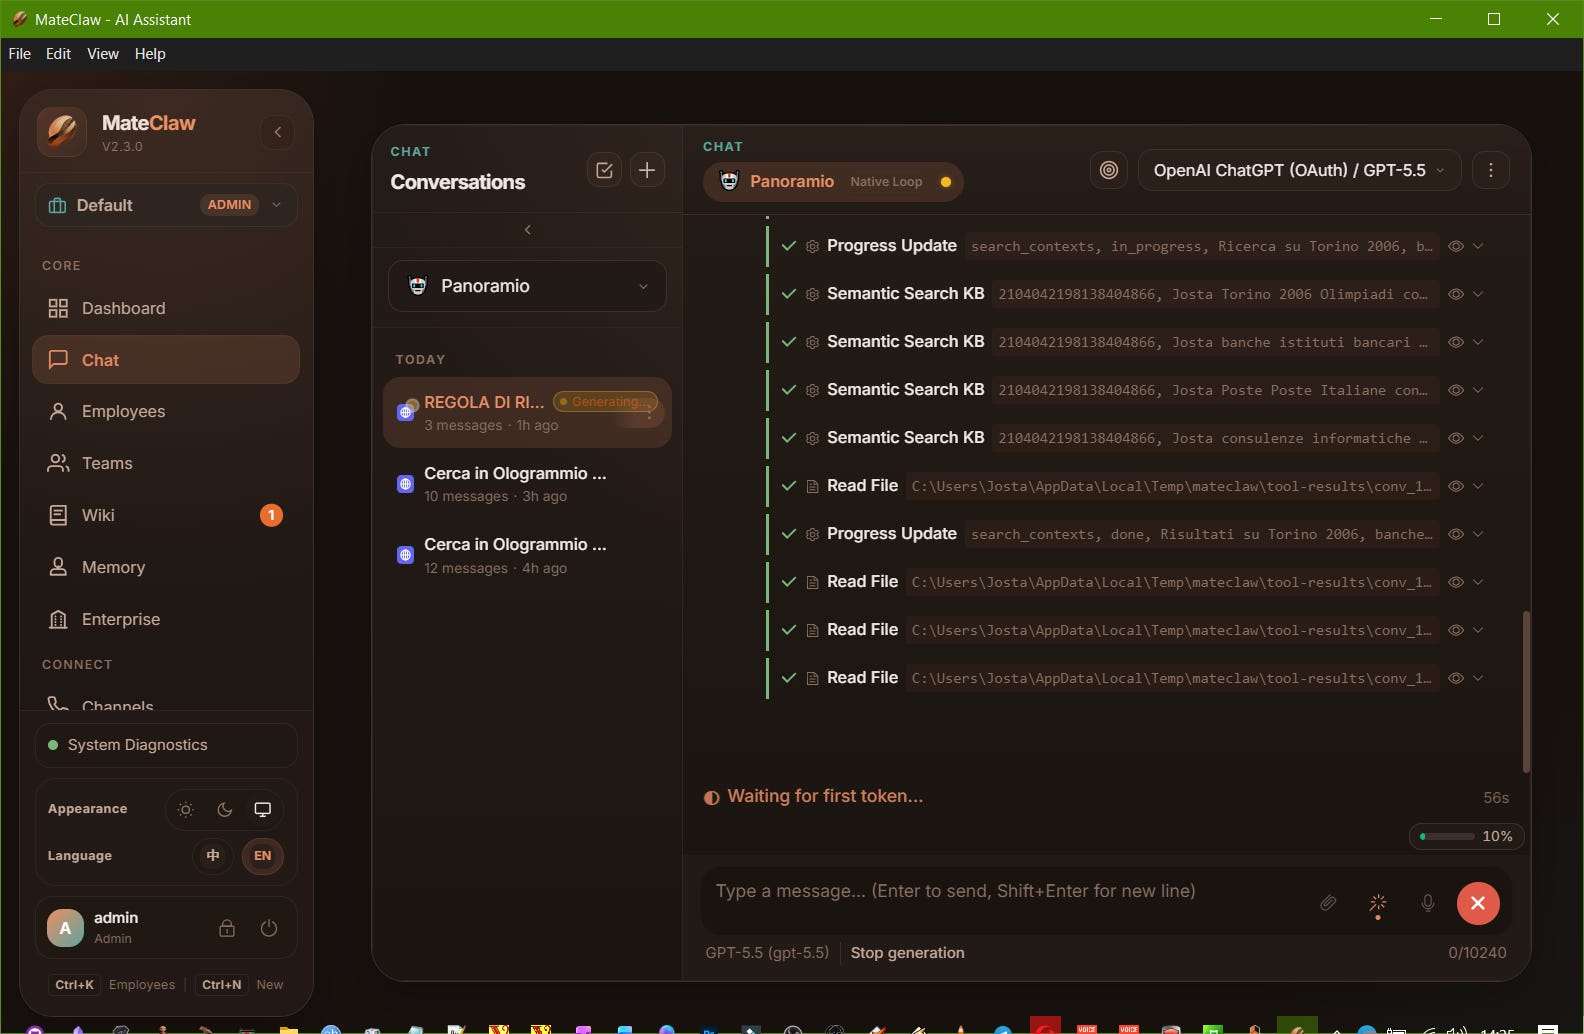
Qui il tempo al primo token cresce: non perché l’agente sia necessariamente bloccato, ma perché prima di parlare esegue più retrieval e organizza le prove.
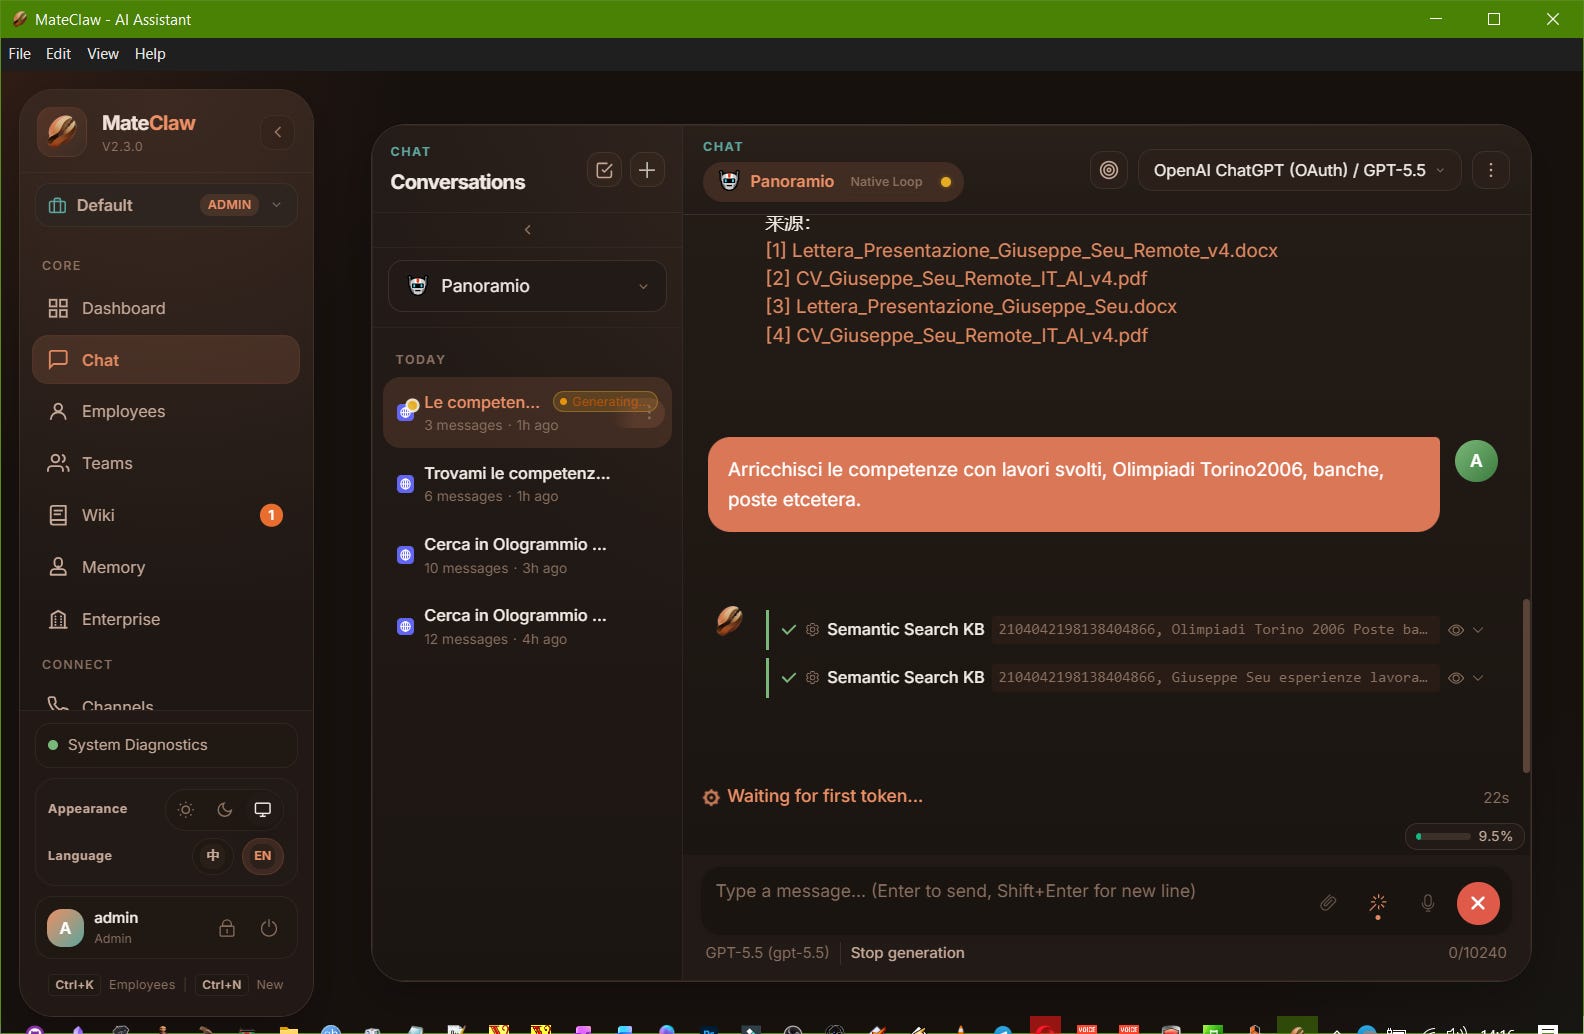
Evidenza E14, Waiting for first token: latenza dopo retrieval multipli, prima dell’inizio dello streaming.
Cartello 1, il facendolo e il fatto compaiono insieme
Sintomo
Durante alcune risposte Wiki-grounded, la UI mostra:
la risposta mentre viene streammata;
la stessa risposta di nuovo dopo la finalizzazione.
In pratica il sistema espone contemporaneamente il facendolo e il fatto.
Non sono due database e non sono necessariamente due ricerche. È la stessa risposta che passa attraverso:
streaming
→ evidence/source normalization
→ finalization
Root cause isolata
In ReasoningNode.java:
String answerWithSources = accessor.sourceEvidenceLedger()
        .appendWikiSourceTable(accumulatedContent);
poi:
.contentStreamed(
    !evidenceInsufficient
    && Objects.equals(answerWithSources, accumulatedContent)
)
Se appendWikiSourceTable(...) modifica il testo aggiungendo o normalizzando le fonti, answerWithSources != accumulatedContent e lo stato finisce per dire che il contenuto non è stato streammato, anche se il corpo è già apparso a video.
In FinalAnswerNode.java il finalizer applica nuovamente:
finalAnswer = accessor.sourceEvidenceLedger()
        .appendWikiSourceTable(finalAnswer);
Il risultato può essere il replay completo del corpo.
Evidenza
Evidenza E02, Punto di sutura fra il primo output streammato e il replay finalizzato.

Report tecnico completo:
issues/01-wiki-stream-finalizer-duplicate-and-citation-remap.md
Cartello 2, il replay non è solo brutto: può cambiare il significato delle citazioni
Questo è il punto che trasforma un difetto visivo in un problema di provenance.
La risposta originale può avere una mappa coerente:
[1] CV_Giuseppe_Seu_Remote_IT_AI_v4.pdf
[2] LLM Evaluation CV IT.docx
[4] Lavori Svolti.txt
[5] ShiduLab.md
[8] ComboCode.md
...
Il corpo usa quei numeri correttamente.
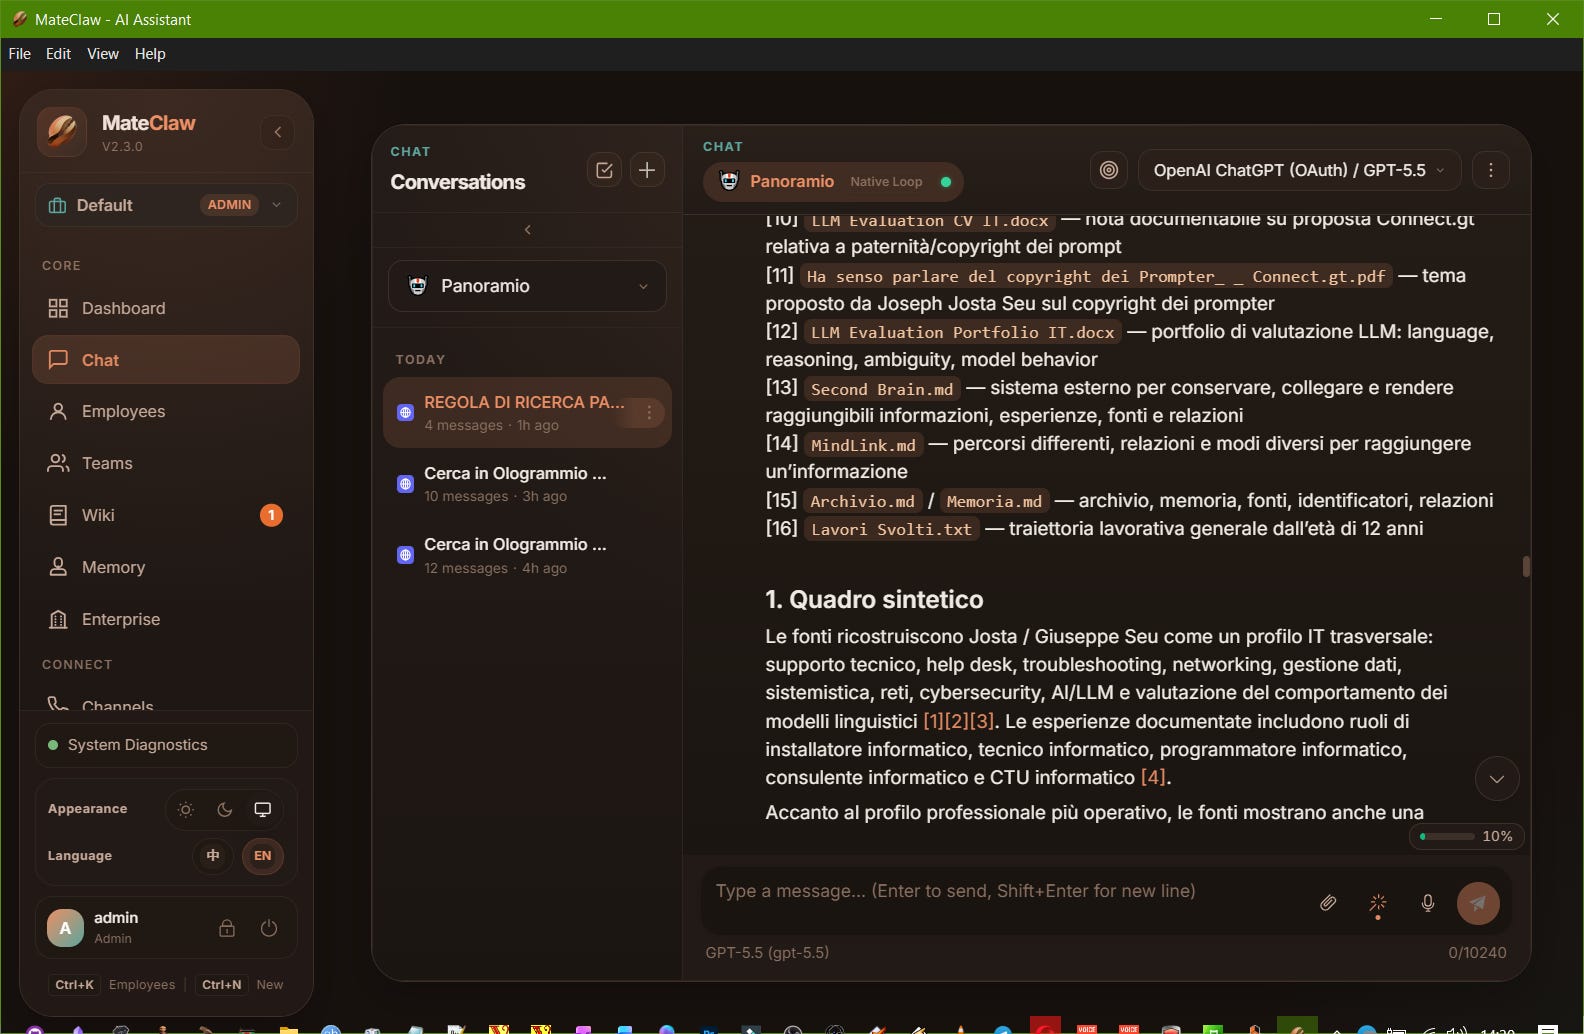
Poi il finalizer ricostruisce una nuova tabella con ordine diverso:
来源:
[1] Lavori Svolti.txt
[2] CV_Giuseppe_Seu_Remote_IT_AI_v4.pdf
[5] Ha senso parlare del copyright dei Prompter_ _ Connect.gt.pdf
...
Il corpo però conserva i vecchi [n].
Quindi un [5] che nel testo significava ShiduLab.md può diventare, nella tabella finale, un PDF sul copyright dei prompt.
Il corpo non è cambiato; è cambiato il dizionario che interpreta i numeri.
Invariante che dovrebbe valere:
Se
[n]è già stato emesso nel corpo, la finalizzazione deve preservare l’identità della sorgenten, oppure deve riscrivere atomicamente sia i marker nel corpo sia la tabella finale.
Evidenza E12, Risposta originale: corpo e mappa numerica delle fonti ancora coerenti prima della rimappatura del finalizer.
Cartello 3, 来源: attraversa il backend e finisce in italiano
Il blocco fonti canonico espone la stringa cinese:
来源:
La UI italiana/inglese se la ritrova tale e quale.
È un piccolo indizio architetturale molto utile: ciò che avrebbe dovuto essere un dettaglio interno di canonicalizzazione è diventato contenuto utente.
Possibili soluzioni:
label i18n-aware;
delimitatore interno non renderizzato;
frontend che interpreti il marker senza mostrarlo letteralmente.
Cartello 4, la conversazione può sedersi sulla propria eco
Accaduto
Creo in Obsidian una nuova nota:
Competenze linguistiche.md
Eseguo Scan in MateClaw:
added 1
status: COMPLETED
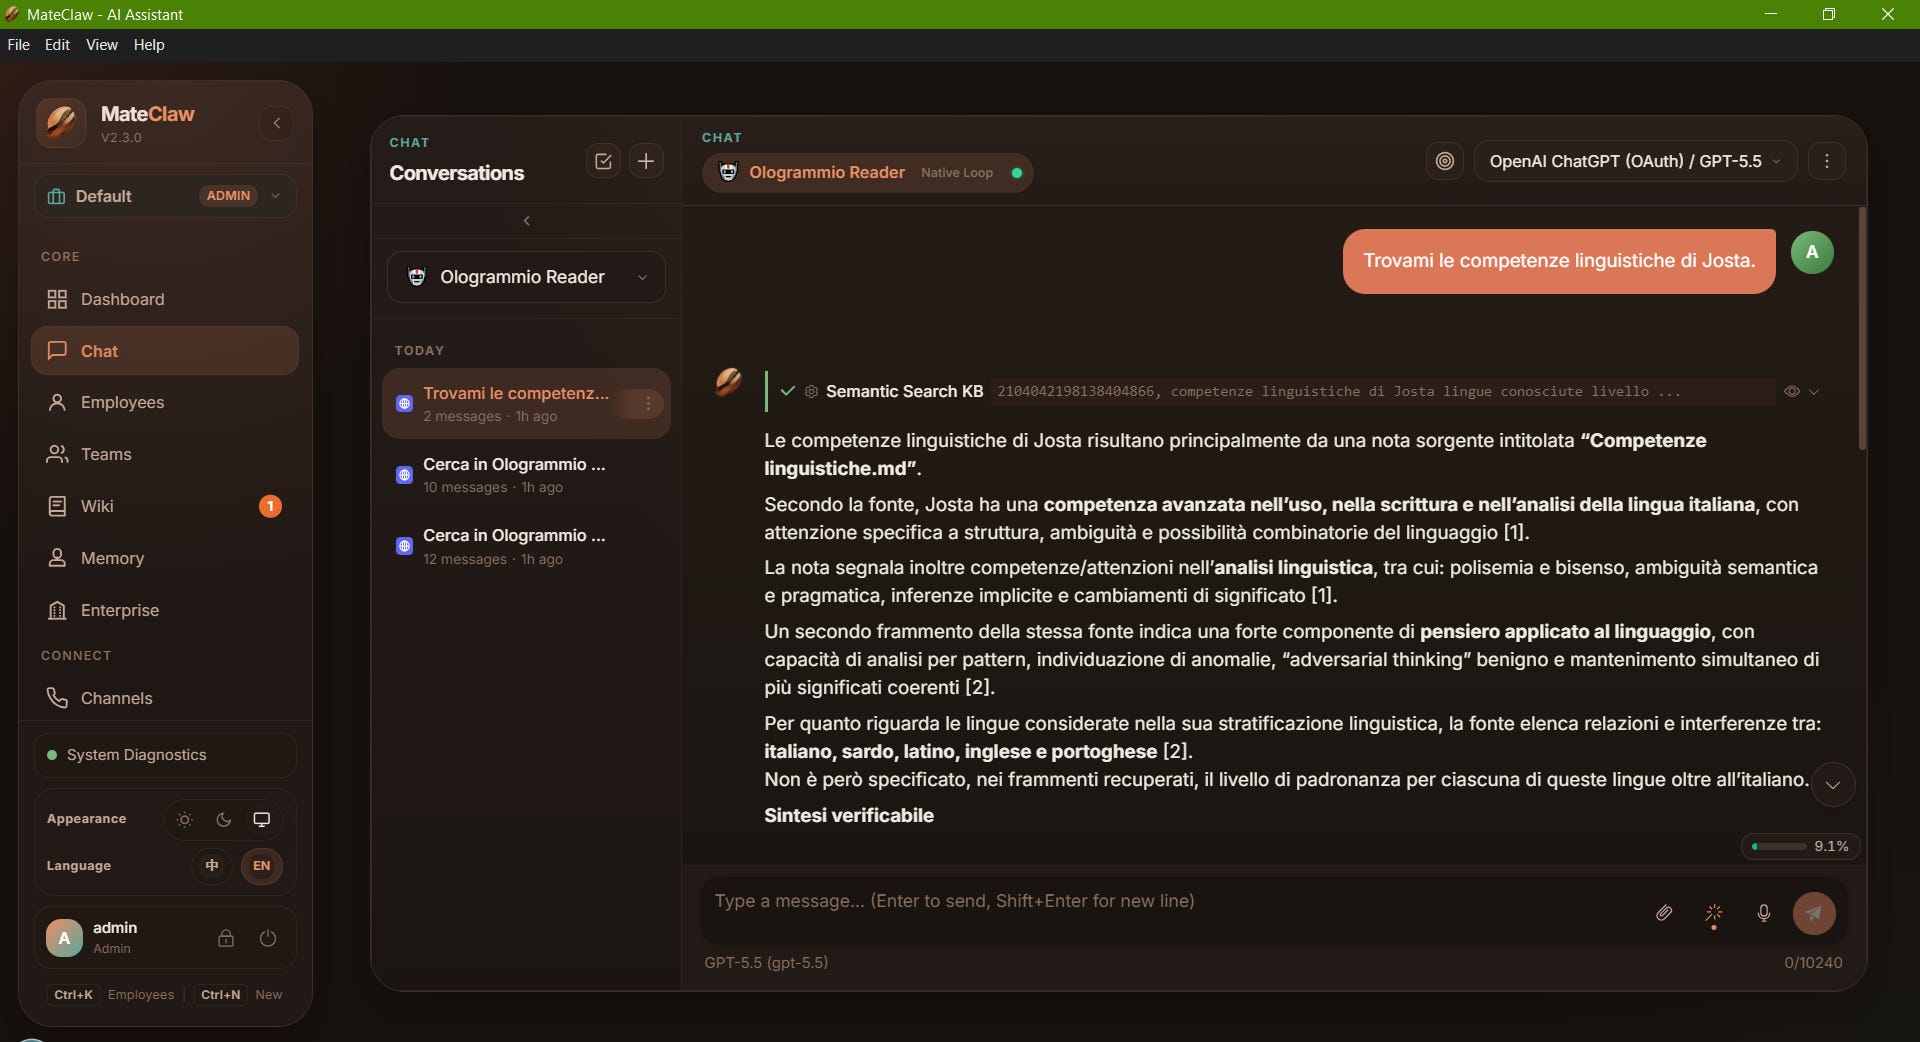
Torno nella conversazione già aperta e rifaccio la domanda. Panoramio risponde usando il grounding precedente e non lancia una nuova Semantic Search KB.
Apro una chat nuova, stessa domanda: la ricerca semantica parte immediatamente e trova la nuova nota.
Evidenza E01, Fresh chat: dopo il rescan della KB, una nuova conversazione rilancia Semantic Search e trova subito la nuova nota.
Stato
Riprodotto. Root cause non ancora isolata.
Ipotesi da verificare: interazione tra conversation history, prior tool evidence e decisione ReAct di non richiamare il retrieval dopo un cambio della KB.
Non viene attribuito senza prova a un generico “buffer della context window”.
Report tecnico:
issues/02-stale-conversation-after-kb-rescan.md
Cartello 5, TXT supportato, ma UTF-16 cade dal ponte
Durante lo scan:
Scanned 46 files, added 11, skipped 34
Failed to import: Lavori Svolti.txt (Input length = 1)
Il file si apriva normalmente in Windows. Era codificato UTF-16.
Nel sorgente attuale, WikiDirectoryScanService.java legge i file testuali così:
String content = Files.readString(realFile, StandardCharsets.UTF_8);
Quindi il .txt è nominalmente supportato, ma lo scan assume UTF-8.
Workaround verificato:
Blocco note
→ Salva con nome
→ Codifica: UTF-8
→ sostituisci file
→ Scan
→ import riuscito
Non lo classifico ancora come vulnerabilità né come root-cause bug complesso: è un pitfall riproducibile di ingest e un buon candidato a charset detection / fallback esplicito.
Vedi:
notes/03-utf16-txt-ingest.md
Cartello 6, cinque cucchiaiate non fanno una panoramica
Il tool wiki_semantic_search dichiara:
@ToolParam(description = "Max results (default 5)", required = false) Integer topK
ed esegue:
int k = (topK != null && topK > 0) ? Math.min(topK, 20) : 5;
Per domande molto larghe, topK=5 può restituire pochi chunk e anche più chunk dello stesso documento. Il risultato sembra “intelligente”, ma può essere magro, parziale e sbilanciato.
La correzione lato Employee non richiede patch:
spezzare la domanda in sotto-query;
usare
topK=20;cercare separatamente entità/periodi/ruoli nominati;
integrare solo dopo;
deduplicare;
distinguere competenze, ruoli, esperienze, strumenti e dotazioni.
Il comportamento cambia radicalmente: invece del mestolino parte il grandangolo.
Cartello 7, Obsidian non è il magazzino: è l’Ologrammio
Non serve duplicare tutto il materiale creativo dentro Obsidian solo per renderlo interrogabile. MateClaw usa un filesystem source: una KB può puntare a una cartella normale.
La separazione che voglio mantenere è:
Ologrammio
→ nodi, mappe, relazioni, sintesi curate

Archivio creativo / professionale
→ documenti, testi, PDF, DOCX, materiale grezzo
Panoramio può essere legato a più KB e fare da sguardo trasversale.
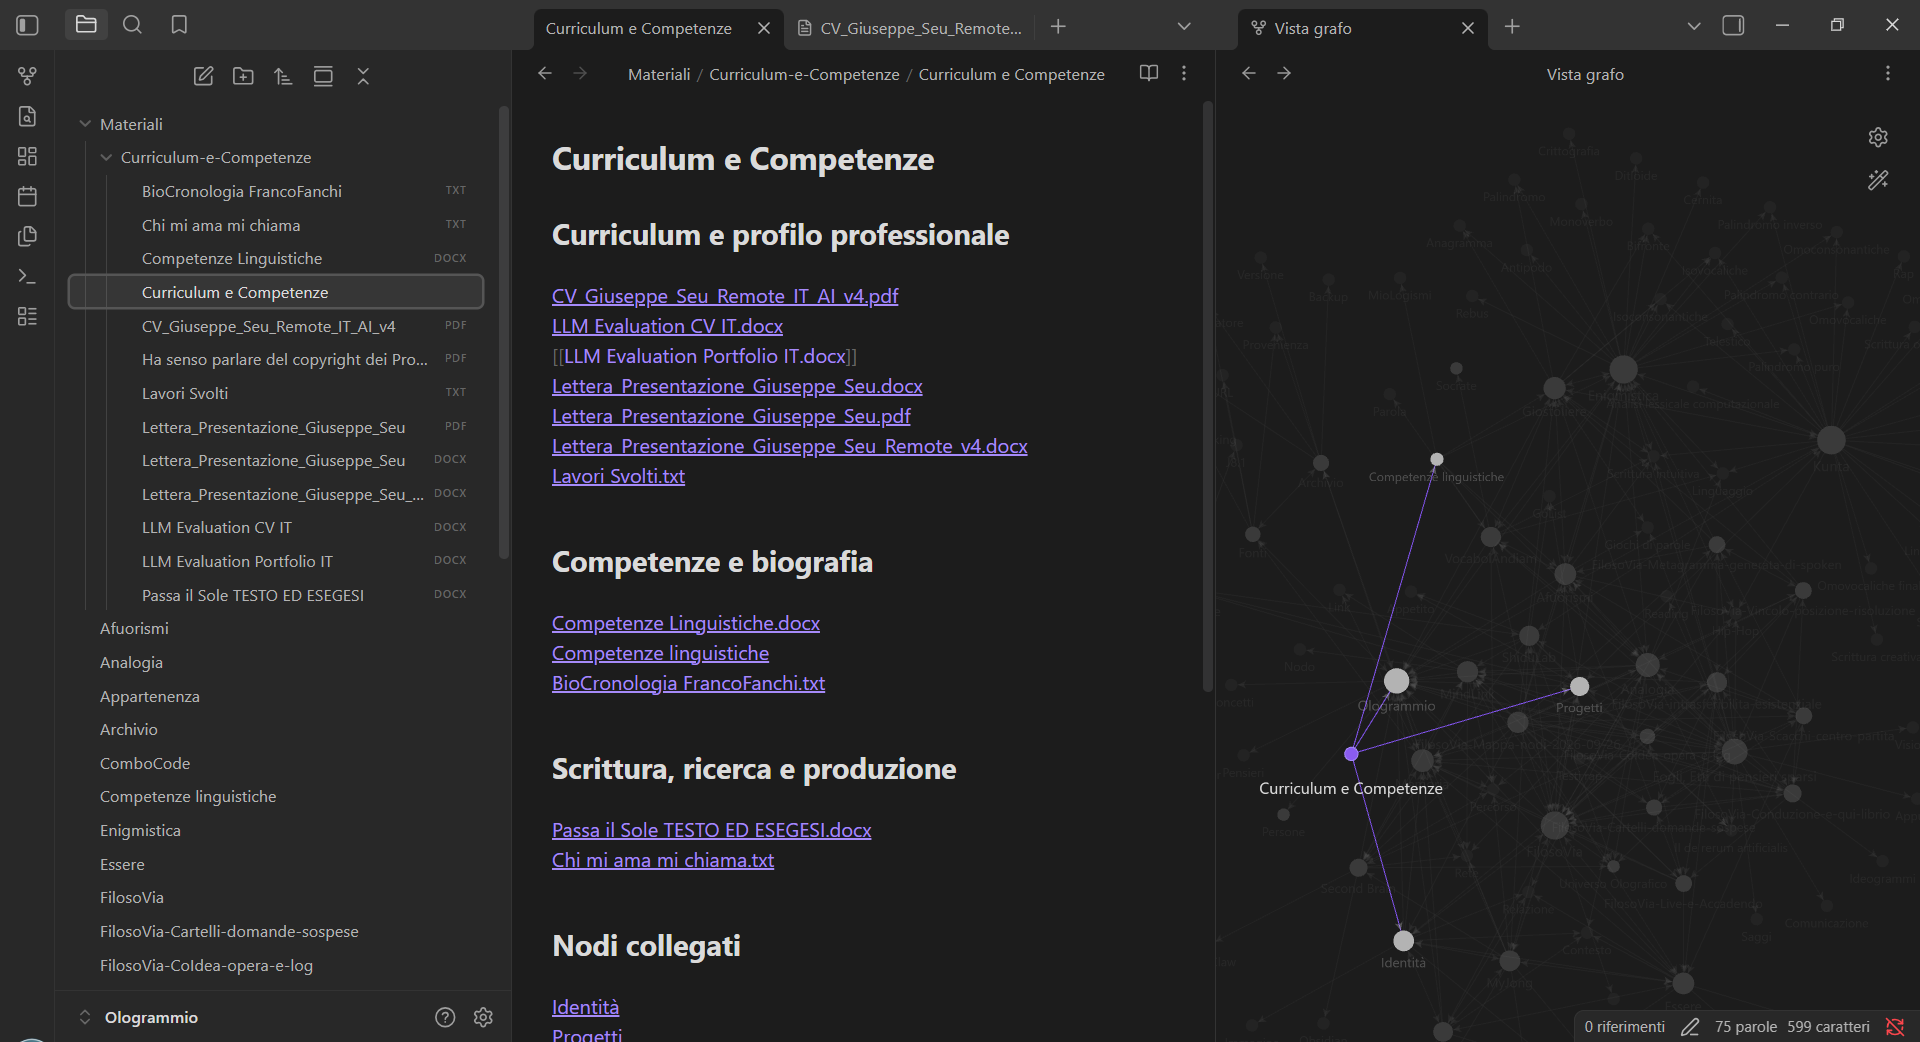
Dentro Ologrammio metto invece ciò che deve diventare nodo: curriculum, competenze, Second Brain, FilosoVia, progetti, connessioni.
Evidenza E13, Curriculum e Competenze diventa un nodo-hub nel grafo Obsidian.
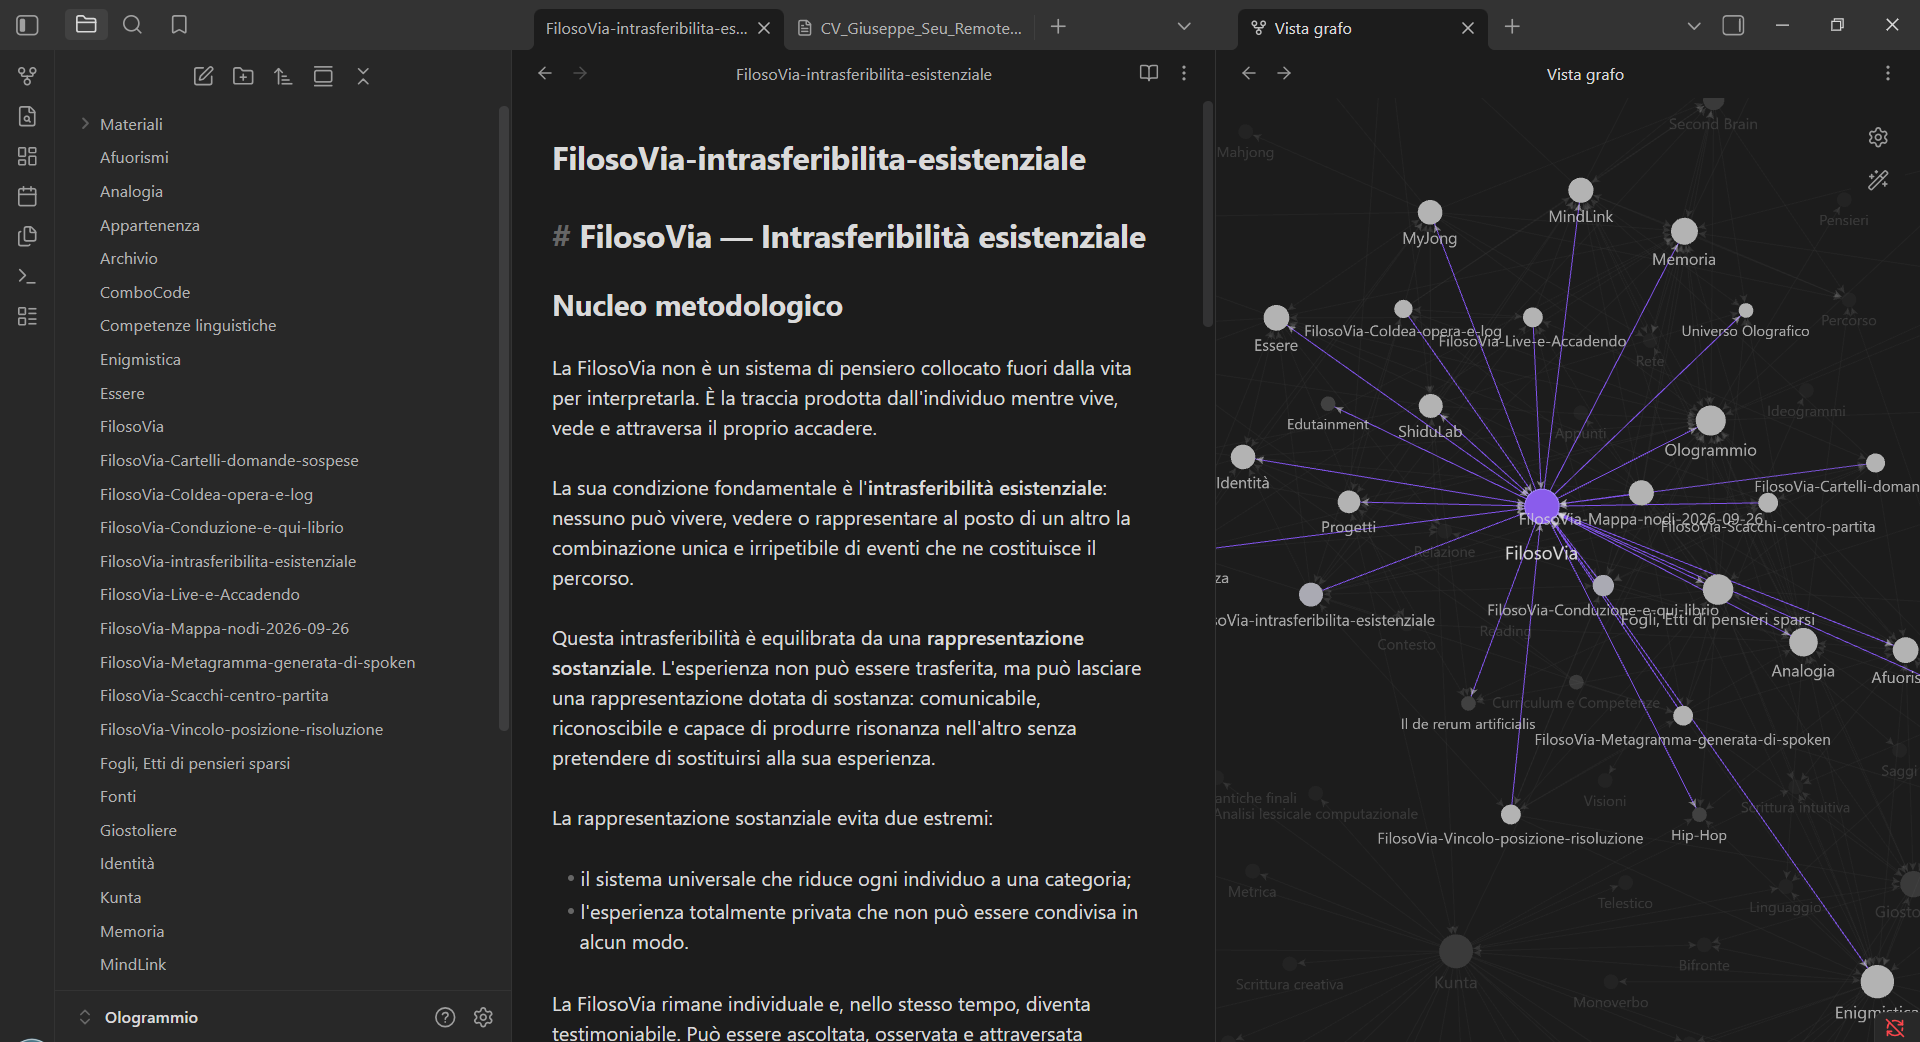
E quando il grafo cresce, quello che nei fumetti sembrava fantascienza diventa interfaccia domestica del pensiero:
Evidenza E10, Panoramio di Ologrammio: il grafo come mappa operativa di nodi e relazioni.
Una cosa che non è un bug, ma cambia il lavoro
La latenza al primo token va letta assieme al workflow.
Una query puntuale può fare una sola ricerca e rispondere presto. Una query panoramica può fare molte Semantic Search, aggiornare il Progress Ledger, leggere risultati intermedi e solo dopo iniziare a generare testo.
Quindi:
TTFT alto != automaticamente blocco
Va osservato insieme a:
numero di tool call;
progress updates;
retrieval effettuati;
dimensione del contesto finale;
eventuale stallo reale.
Cose viste ma non ancora isolate
Raw Wiki-link HTML leakage
In una risposta semantica è comparso HTML interno del wikilink, ad esempio una forma tipo:
<a class="wiki-link" ...>VocabolAndiam</a>
Da separare dal bug del replay finché non viene dimostrato un percorso comune.
Conversation-state ↔ duplicate replay
Il replay non avviene su ogni singola query. In una fresh chat, dopo l’aggiunta di una nuova nota, una risposta è comparsa una sola volta. Lo stato conversazionale sembra avere un ruolo, ma la relazione causale va ancora dimostrata.
Il metodo Artistagiano
Il percorso reale non è stato:
leggere manuale
→ configurare tutto perfettamente
→ usare
È stato:
INSTALLARE
    ↓
SETTARE
    ↓
USARE
    ↓
OSSERVARE
    ↓
ROMPERE / FAR EMERGERE
    ↓
LEGGERE IL SORGENTE
    ↓
RIPRODURRE
    ↓
ISOLARE
    ↓
SCRIVERE IL CARTELLO
    ↓
TORNARE A COSTRUIRE
Installazione / Set / Test / Report Bugs non sono quattro reparti separati. Nel lavoro reale possono stare nella stessa persona e nella stessa ora.
Solo costruendo il ponte su cui si cammina, col materiale già usato. Passando e ripassando, accantonando e decantando.
Questo è il senso di BUGHUNTED DURANTED: non vado a caccia di bug come attività separata. Li incontro mentre sto facendo altro, li fermo, li guardo, li segno e continuo.
Un cartello non è il bosco.
Serve a chi ci passerà dopo.
Accadrà?
Le prove successive utili sono già implicite nei problemi trovati:
test A/B
maxIterations=6vs10sullo stesso scenario, senza cambiare altro;test automatico stream → normalize → finalize che garantisca un solo corpo visibile;
test atomico della mappa
[n] → sourcedopo piùwiki_semantic_search;invalidazione/versionamento del grounding conversazionale dopo KB rescan;
charset detection o messaggio esplicito per
.txtnon UTF-8;test i18n del source-table header;
test dedicato al leakage di raw Wiki-link HTML;
misura TTFT correlata a numero di tool call e dimensione del retrieval.
Non è una sentenza sul progetto. È una fotografia del sistema mentre accade.
E per questo, più che una review, è una vivovedocronaca.
JostaDev 👀 #MateClaw
(Parte 2, il giorno dopo :D
Metriche alla mano…)
https://shidulab.github.io/BUGHUNTED-Duranted/